Kitten-TTS 2 — локальный синтез речи и клонирование голоса
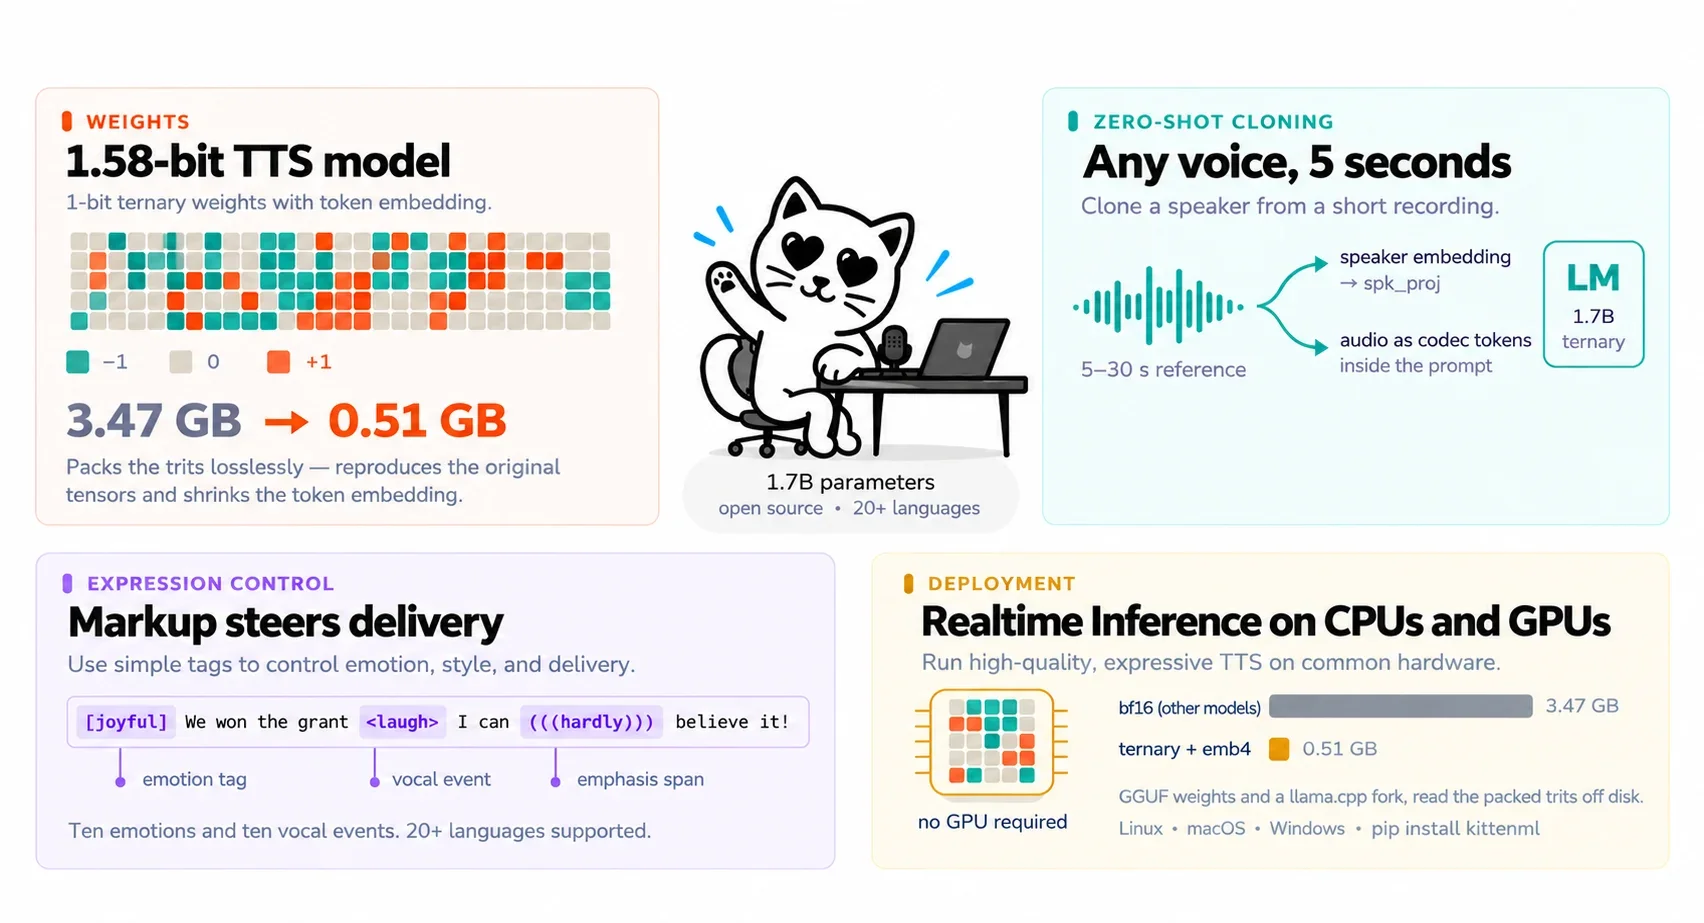
Kitten-TTS 2 синтезирует речь локально, клонирует голос по записи 5–30 секунд и заявляет поддержку 20 языков, включая русский.
Kitten-TTS 2 превращает текст в речь и умеет подстраивать звучание под короткую запись голоса. Разработчик указывает, что для клонирования достаточно 5–30 секунд речи одного человека: отдельно обучать модель на новом голосе не нужно. Синтез можно запускать на компьютере локально, в том числе на процессоре без видеокарты. Для сравнения с компактной моделью предыдущего поколения посмотрите страницу KittenTTS 0.8.
- Как работает клонирование голоса
- Короткая запись становится образцом
- Есть и готовые голоса
- Какие языки поддерживает модель
- Русский входит в список разработчика
- Локальный запуск и требования к компьютеру
- Видеокарта не обязательна
- Пример синтеза через Python
- Для каких задач подойдёт Kitten-TTS 2
- Озвучивание и прототипирование
- Лицензия и использование клонированного голоса
- Код и веса распространяются на разных условиях
Как работает клонирование голоса
Короткая запись становится образцом
Вместо готового голоса в настройке модели указывают аудиозапись одного говорящего. Kitten-TTS 2 использует её как образец тембра и манеры речи, а затем озвучивает заданный текст. По документации проекта, отдельное дообучение или создание собственного набора данных не требуются. Если рядом с записью не передать её расшифровку, пакет может получить текст с помощью Whisper; если передать его сразу, этот дополнительный шаг можно пропустить.
Есть и готовые голоса
Для синтеза без собственной записи предусмотрено 115 встроенных голосов. В текст можно добавлять поддерживаемые указания об эмоции, паузе, смехе или ударении. Это ранняя экспериментальная функция: метки влияют на интонацию, но не гарантируют одинаковый результат на любом голосе и предложении.
Какие языки поддерживает модель
Русский входит в список разработчика
В README перечислены 20 языков: английский, арабский, китайский, французский, немецкий, хинди, итальянский, португальский, русский, испанский, японский, корейский, турецкий, нидерландский, шведский, датский, финский, суахили, греческий и иврит. При этом справочник голосов отдельно описывает именные встроенные голоса для 16 языков. Это не означает, что на каждом языке доступны одинаковый выбор голосов и одинаковое качество: команда предупреждает, что неанглоязычные голоса опираются на меньший набор образцов и могут звучать менее стабильно.
Есть и практическая оговорка для русского и других языков, кроме английского: встроенная нормализация текста лучше настроена на английские числа, даты и сокращения. В документации для неанглоязычного текста рекомендуется отключать её параметром normalize=False и проверять, как модель произносит числа и аббревиатуры.
Локальный запуск и требования к компьютеру
Видеокарта не обязательна
Kitten-TTS 2 можно запускать на Windows, macOS и Linux. В инструкции указаны Python 3.10 или новее, около 6 ГБ оперативной памяти для запуска на CPU и примерно 2 ГБ свободного места с учётом модели, декодера и зависимостей. GPU — дополнительный вариант: для CUDA разработчик приводит ориентир около 8 ГБ свободной видеопамяти. На компьютерах Apple с процессорами серии M доступен отдельный ускоренный режим MLX.
Основные веса модели занимают примерно 954 МБ; облегчённый вариант — около 0,5 ГБ, но в нём снижена точность части весов, поэтому возможна небольшая потеря качества. Это размер файлов модели, а не требование к объёму оперативной памяти: для процессорного запуска документация указывает около 6 ГБ RAM.
Пример синтеза через Python
Пакет устанавливается командой pip install kittenml. Например, можно передать модели русский текст и собственную запись, а результат сохранить в WAV:
from kittenml import KittenTTS
import soundfile as sf

model = KittenTTS("KittenML/kitten-tts-2")
audio = model.generate(
    "Добрый день. Это пример локального синтеза речи.",
    reference="my_voice.wav",
    normalize=False,
)
sf.write("speech.wav", audio, model.sample_rate)
При таком способе текст и запись передаются локальному экземпляру модели. Первый запуск скачивает необходимые файлы; после загрузки модель выполняет синтез на выбранном устройстве. У KittenML также есть отдельная веб-площадка с облачным API — её не следует путать с локальным запуском.
Для каких задач подойдёт Kitten-TTS 2
Озвучивание и прототипирование
Модель можно встроить в локальное приложение, использовать для черновой озвучки, голосовых интерфейсов, диалоговых персонажей и экспериментов с синтезом на русском. Разработчик также заявляет работу в реальном времени на CPU, но фактическая скорость зависит от процессора, настроек и длины текста; перед использованием в продукте её стоит замерить на целевом компьютере.
Kitten-TTS 2 создаёт речь из текста. Если задача обратная — получить текстовую расшифровку из аудиозаписи, — посмотрите Phonon-2.5. Из других моделей для синтеза можно сравнить Ming-3.0-TTS 0.5B.
Лицензия и использование клонированного голоса
Код и веса распространяются на разных условиях
Код библиотеки KittenTTS опубликован под Apache 2.0, но веса Kitten-TTS 2 используют отдельную Stellon Labs Community License. Она разрешает исследовательское и личное применение без оплаты, а для коммерческого использования устанавливает дополнительные условия: в частности, нужна регистрация у разработчика; при годовой выручке или совокупном финансировании свыше 1 млн долларов требуется отдельное разрешение. При распространении весов или продукта на их основе действуют требования к уведомлению и указанию KittenML. Перед коммерческим внедрением проверьте полный текст лицензии модели.
Клонировать стоит только собственный голос или голос человека, который дал на это согласие. Если синтетическая речь может быть принята за запись реального человека, обозначьте её искусственное происхождение.