Liquid AI LFM3 — семейство локальных ИИ-моделей
LFM3 — шесть моделей Liquid AI для текста, изображений, видео, аудио и классификации. Разбираем возможности, запуск и ограничения семейства.
LFM3 — семейство компактных моделей Liquid AI с открытыми весами. Вместо одного универсального помощника разработчик предлагает выбрать модель под задачу: вести диалог и вызывать инструменты, разбирать фотографии и видео, распознавать речь или выдавать структурированные решения с оценкой уверенности.
Все шесть вариантов построены на общей основе, но каждый получил собственные компоненты для работы с определённым типом данных. Модели рассчитаны на запуск рядом с приложением — на компьютере, сервере или устройстве на границе сети. Это может сократить зависимость от облачного API и оставить больше контроля над данными, если весь рабочий процесс действительно запущен локально.
- Шесть моделей для разных задач
- LFM3-1.7B — текст и ИИ-агенты
- LFM3-VL-2B — изображения и видео
- LFM3-Audio-2B — распознавание и генерация речи
- LFM3-Omni-2B — совместная работа с голосом и изображением
- d1-2B и d1-Omni-2B — классификация и решения в заданном формате
- Как устроена общая архитектура
- Настройка под собственную задачу
- Запуск и совместимость
- Лицензия и ограничения
- Где посмотреть модели и документацию
Шесть моделей для разных задач
LFM3-1.7B — текст и ИИ-агенты
Текстовая модель подходит для диалога, структурированных ответов и вызова инструментов. Её можно подключить к локальному агенту, который выполняет несколько последовательных шагов: например, ищет сведения, разбирает результат и передаёт его дальше. Контекст модели достигает 256 тысяч токенов — это большой объём переписки и документов, который модель может учитывать в одном запросе.
Liquid AI указывает, что веса текстовой модели в формате 4-bit занимают около 1 ГБ. Это размер самих сжатых весов, а не гарантия, что весь процесс поместится в гигабайт оперативной памяти: дополнительная память нужна для контекста, кэша, среды запуска и самой операционной системы.
LFM3-VL-2B — изображения и видео
Вариант VL принимает текст, изображения и видео, а отвечает текстом. Ему можно поручить разобрать снимок документа, прочитать график, найти объект на кадре или объяснить, что происходит в ролике. В документации Liquid AI для этой модели указан контекст до 128 тысяч токенов. Для видео система анализирует выбранные кадры; это не означает, что модель непрерывно обрабатывает каждую секунду записи.
LFM3-Audio-2B — распознавание и генерация речи
Аудиомодель принимает голос или текст и может вернуть текст, речь либо сочетание обоих форматов. Среди заявленных сценариев — распознавание речи, голосовой диалог, понимание звуков, синтез речи и выполнение команд через инструменты. Liquid AI заявляет поддержку 18 языков. Причинная обработка звука позволяет начинать анализ до того, как человек закончит говорить; фактическая задержка зависит от оборудования и программной сборки.
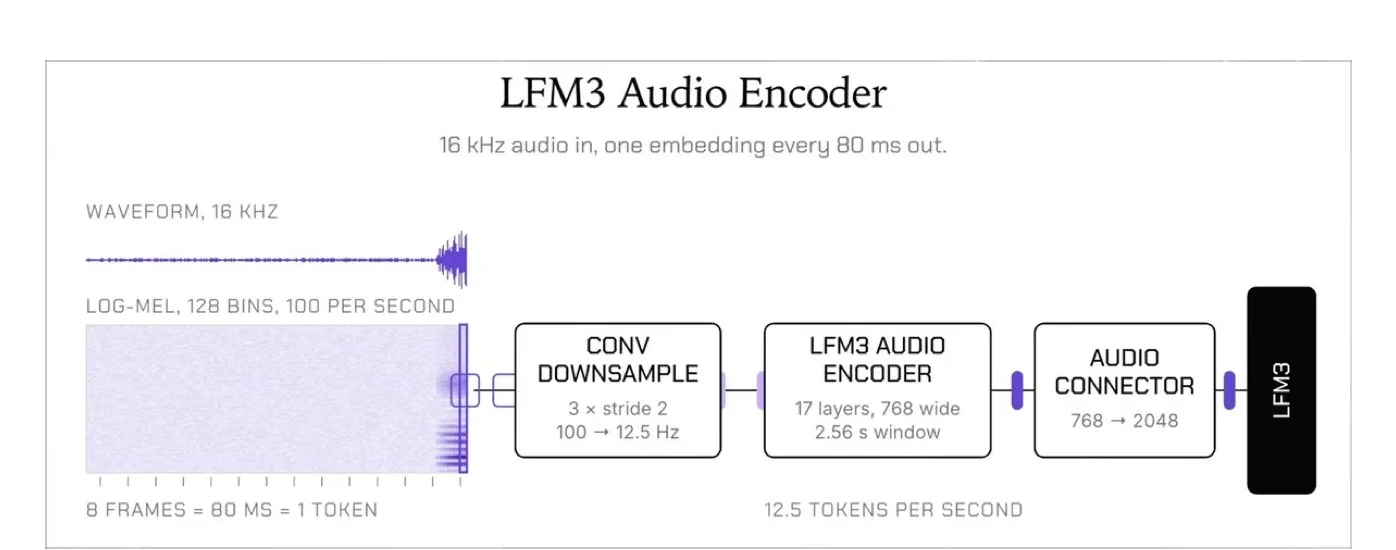
LFM3-Omni-2B — совместная работа с голосом и изображением
Omni объединяет текст, изображения, видео и аудио в одной модели. Например, ей можно показать фотографию и задать вопрос голосом или попросить разобрать ролик вместе со звуковой дорожкой. В ответ она создаёт текст или речь, а в поддерживаемом сценарии может сформировать вызов инструмента. Это удобно для голосовых помощников, интерфейсов с камерой и локальных приложений, где важно учитывать одновременно то, что человек говорит и показывает.
d1-2B и d1-Omni-2B — классификация и решения в заданном формате
Семейство d1 устроено иначе, чем разговорные модели. Разработчик задаёт набор вопросов и допустимые варианты ответа, а модель возвращает структурированный результат: например, определяет тему обращения, предлагает отдел для его обработки, оценивает срочность или извлекает значения из документа. d1-2B работает с текстом, изображениями и видео; d1-Omni-2B также принимает аудио.
К ответам d1 прилагаются вероятностные оценки. Их полезно воспринимать как сигналы для сортировки и принятия решения, а не как гарантию правильности: критические результаты всё равно следует проверять по правилам приложения или человеком.
Как устроена общая архитектура
В основе текстовой LFM3-1.7B — 24 слоя трёх типов. Короткие свёртки быстро обрабатывают соседние фрагменты текста; скользящее внимание связывает близкие части контекста; глобальное внимание помогает учитывать удалённые фрагменты. Упрощённо, модель сочетает быстрый разбор локальных деталей с возможностью сопоставлять их с более длинной историей.
Такое устройство важно для локальных систем: скорость зависит не только от числа параметров, но и от того, сколько операций требуется для обработки каждого нового фрагмента. Liquid AI проектировала архитектуру с измерениями на телефонах, ноутбуках, одноплатном Raspberry Pi, процессорах, видеокартах и нейропроцессорах. Это не означает одинаковую скорость на всех этих устройствах, но показывает, что ограничения конкретного оборудования учитывались при разработке.
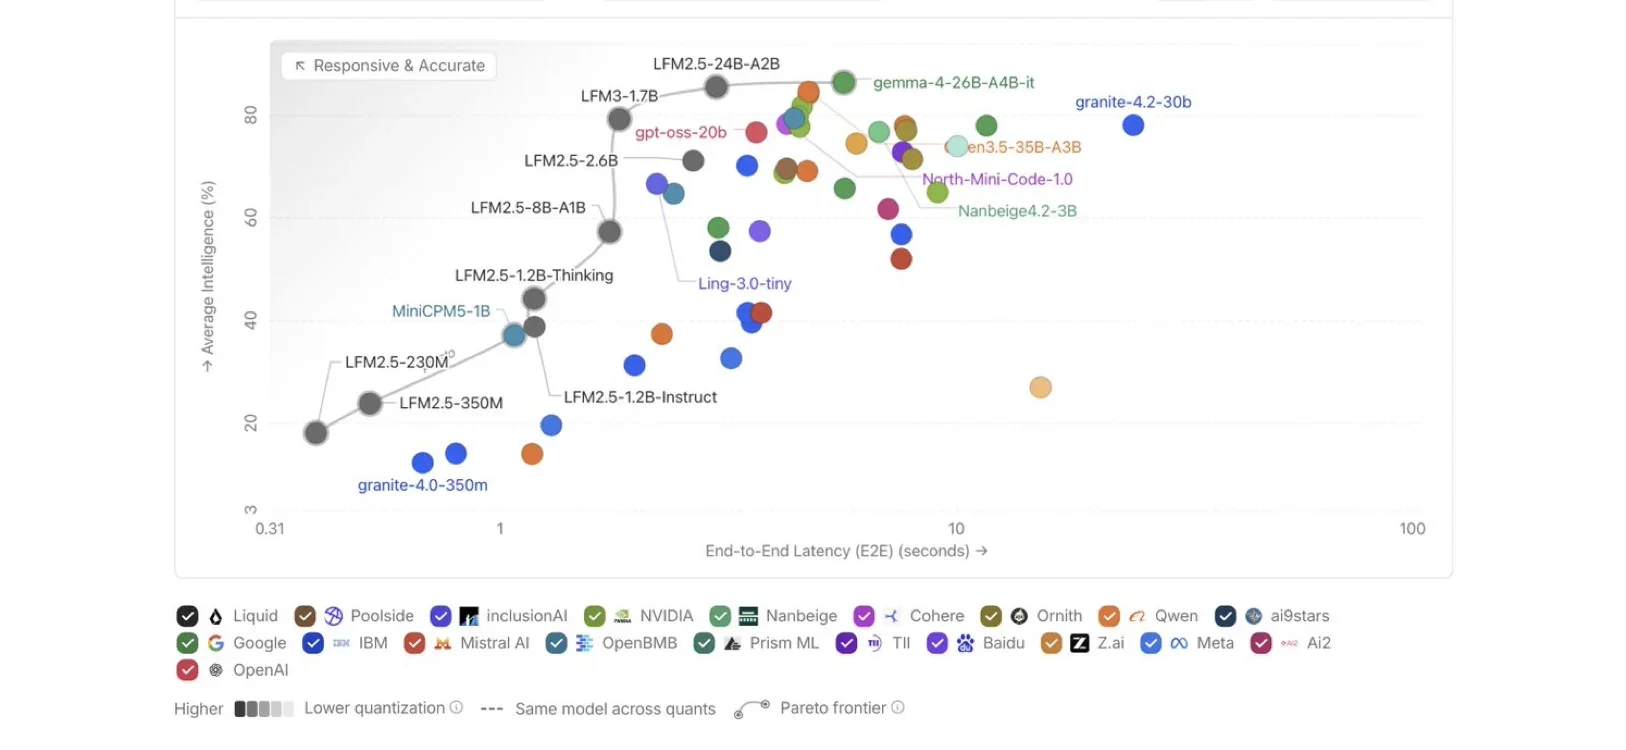
Компания также сообщает, что LFM3-1.7B превзошла LFM2.5-2.6B в выбранных проверках, имея на 35% меньше параметров. В среднем на 62 тестах для зрения Liquid AI приводит результат 71,4 для LFM3-VL-2B против 57,6 у предыдущей LFM2.5-VL-3B. Это данные производителя на его наборах тестов; они не заменяют проверку на собственных запросах и оборудовании.
Настройка под собственную задачу
Семейство рассчитано не только на запуск готовых весов. Liquid AI публикует примеры дообучения: текстовую модель настраивают для вызова нужных инструментов или извлечения данных в JSON, VL — для чтения чеков и распознавания формул, аудиомодель — для команд умного дома и работы с голосом. Компания сообщает, что каждую модель можно дообучить на одной видеокарте. На практике требования к памяти зависят от выбранного варианта, точности весов, размера обучающих данных и метода настройки.
Запуск и совместимость
Весовые файлы семейства опубликованы на Hugging Face. Для текстовой и визуальной моделей доступны варианты для разных сред локального запуска, включая Transformers, GGUF для llama.cpp, MLX для компьютеров Apple и ONNX. Набор готовых форматов отличается от модели к модели: например, документация на момент публикации указывает, что у LFM3-Audio-2B вариант GGUF ещё ожидается. Перед загрузкой проверьте карточку именно той модели, которая вам нужна.
Начать выбор можно с простой схемы: LFM3-1.7B — для текста и локальных агентов; LFM3-VL-2B — если нужны изображения или видео; LFM3-Audio-2B — для голосовых сценариев; Omni — если нужно объединить звук и изображение; d1 — если приложению нужны размеченные решения, а не свободный диалог. Сборка для устройства пользователя и серверное развёртывание требуют разных форматов и настроек.
Лицензия и ограничения
Liquid AI называет модели открытыми по весам и публикует их для скачивания и дообучения. Условия коммерческого использования описаны в лицензии LFM Open License: по информации компании, для бизнеса с выручкой менее 10 млн долларов в год использование открытых моделей в производстве бесплатно; компаниям выше этого порога требуется коммерческая лицензия. Для исследований, образования и некоммерческого использования компания указывает отдельные условия. Перед запуском продукта сверьте актуальную лицензию и ограничения конкретной модели.
Локальный запуск даёт больше контроля над передачей данных, но сам по себе не гарантирует приватность. Она зависит также от приложения, журналов, подключённых инструментов и сетевых запросов. У небольших моделей есть и обычные ограничения: они могут ошибаться, терять детали длинного задания и выдавать неверные классификации. Для финансовых, медицинских и иных ответственных решений нужны проверки и резервный сценарий.
Где посмотреть модели и документацию
В коллекции LFM3 собраны веса семейства и ссылки на доступные форматы. Список контекстных ограничений, поддерживаемых движков и рекомендации по запуску приведены в документации Liquid AI. Полное описание архитектуры и результаты тестов опубликованы в техническом разборе LFM3. О разработчике можно прочитать в статье о Liquid AI в Вики FutureTools; о предыдущей текстовой модели — на странице LFM2.5-2.6B.