Unlimited OCR 2 от Baidu — ИИ для разбора длинных документов
Unlimited OCR 2 от Baidu распознаёт многостраничные документы, сохраняя связи между страницами. Модель с открытой лицензией MIT использует механизм SR-SWA.
Unlimited OCR 2 — открытая модель Baidu для распознавания и разбора многостраничных документов. Она рассчитана на длинные файлы: отчёты, книги, договоры, инструкции и другие материалы, где ответ на одной странице может зависеть от того, что сказано на предыдущих.
Модель и веса: Unlimited OCR 2 на Hugging Face
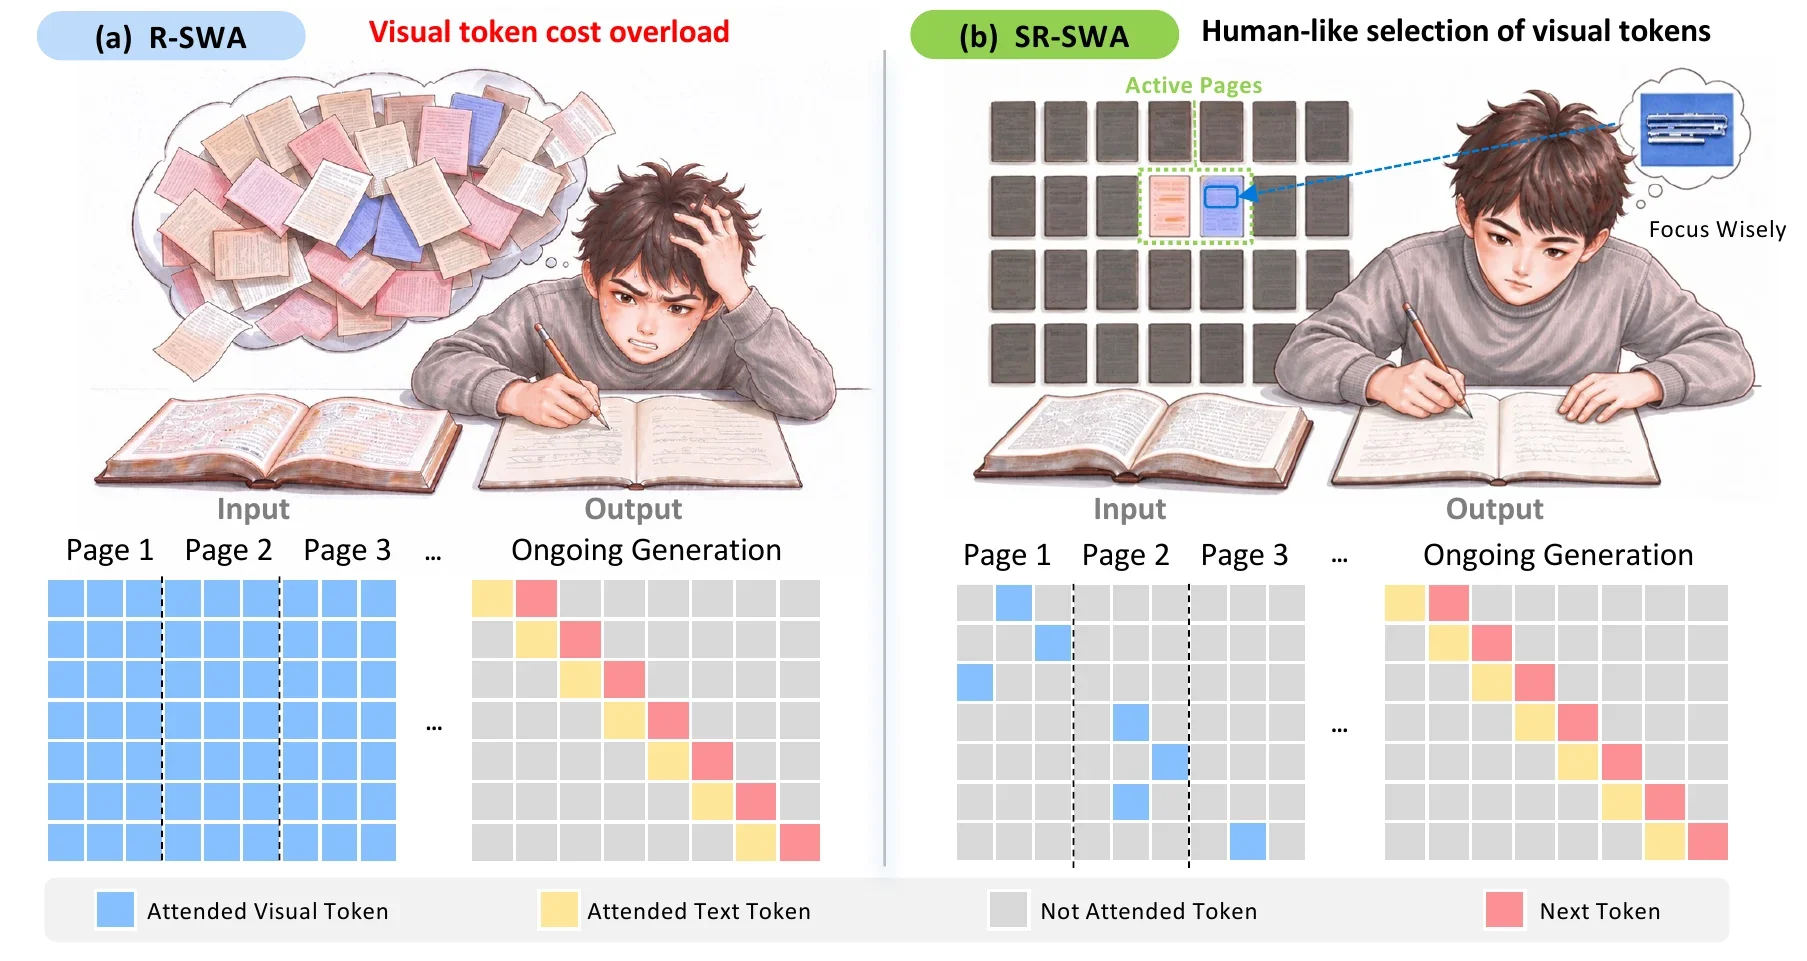
Версия 2 появилась 27 октября 2026 года. Её главная идея — не заставлять модель заново учитывать все страницы на каждом шаге генерации. Для этого Baidu разработала механизм SR-SWA, который оставляет ограниченный набор визуальных ориентиров и использует его как рабочую память.
- Зачем OCR нужна работа с несколькими страницами
- Как Unlimited OCR 2 сокращает повторные вычисления
- SR-SWA выбирает рабочие ориентиры
- Постраничная структура сохраняется
- Что показывают опубликованные результаты
- Кому пригодится модель
- Как запустить Unlimited OCR 2
- Transformers для первых экспериментов
- SGLang для сервера
- Что означает слово Unlimited
Зачем OCR нужна работа с несколькими страницами
Обычная задача распознавания часто сводится к одной странице: найти текст на изображении и превратить его в строки. В длинном документе этого мало. Таблица может продолжаться на следующей странице, определение — объясняться в начале главы, а нужный вывод — зависеть от нескольких частей отчёта.
Если на каждом шаге обработки модель повторно обращается ко всему накопленному визуальному контексту, расчёты и использование памяти растут вместе с длиной документа. Это особенно заметно при генерации длинного результата: модель должна не только увидеть страницы, но и последовательно выдать распознанный текст.
Как Unlimited OCR 2 сокращает повторные вычисления
SR-SWA выбирает рабочие ориентиры
SR-SWA расшифровывается как Sparse Reference Sliding Window Attention — разреженное внимание с опорными точками и скользящим окном. Вместо того чтобы каждый раз сопоставлять новый фрагмент со всеми визуальными токенами документа, модель сжимает взаимодействие текста и изображений в небольшой фиксированный набор ориентиров. В описании Baidu в качестве примера приводится набор примерно из 512 токенов.
На практике это похоже на работу с закладками: при чтении длинного отчёта человек держит перед собой текущую страницу и возвращается к тем местам, которые важны для ответа. Модель использует похожий принцип отбора опорных фрагментов, чтобы не пересчитывать весь просмотренный документ на каждом шаге.
Постраничная структура сохраняется
В режиме infer_multi разработчик передаёт изображения страниц по порядку одним запросом. Модель может учитывать связи между ними, а в результате отмечает границы страниц специальным маркером. Это упрощает последующую проверку текста и сопоставление фрагмента с исходным листом.
Что показывают опубликованные результаты
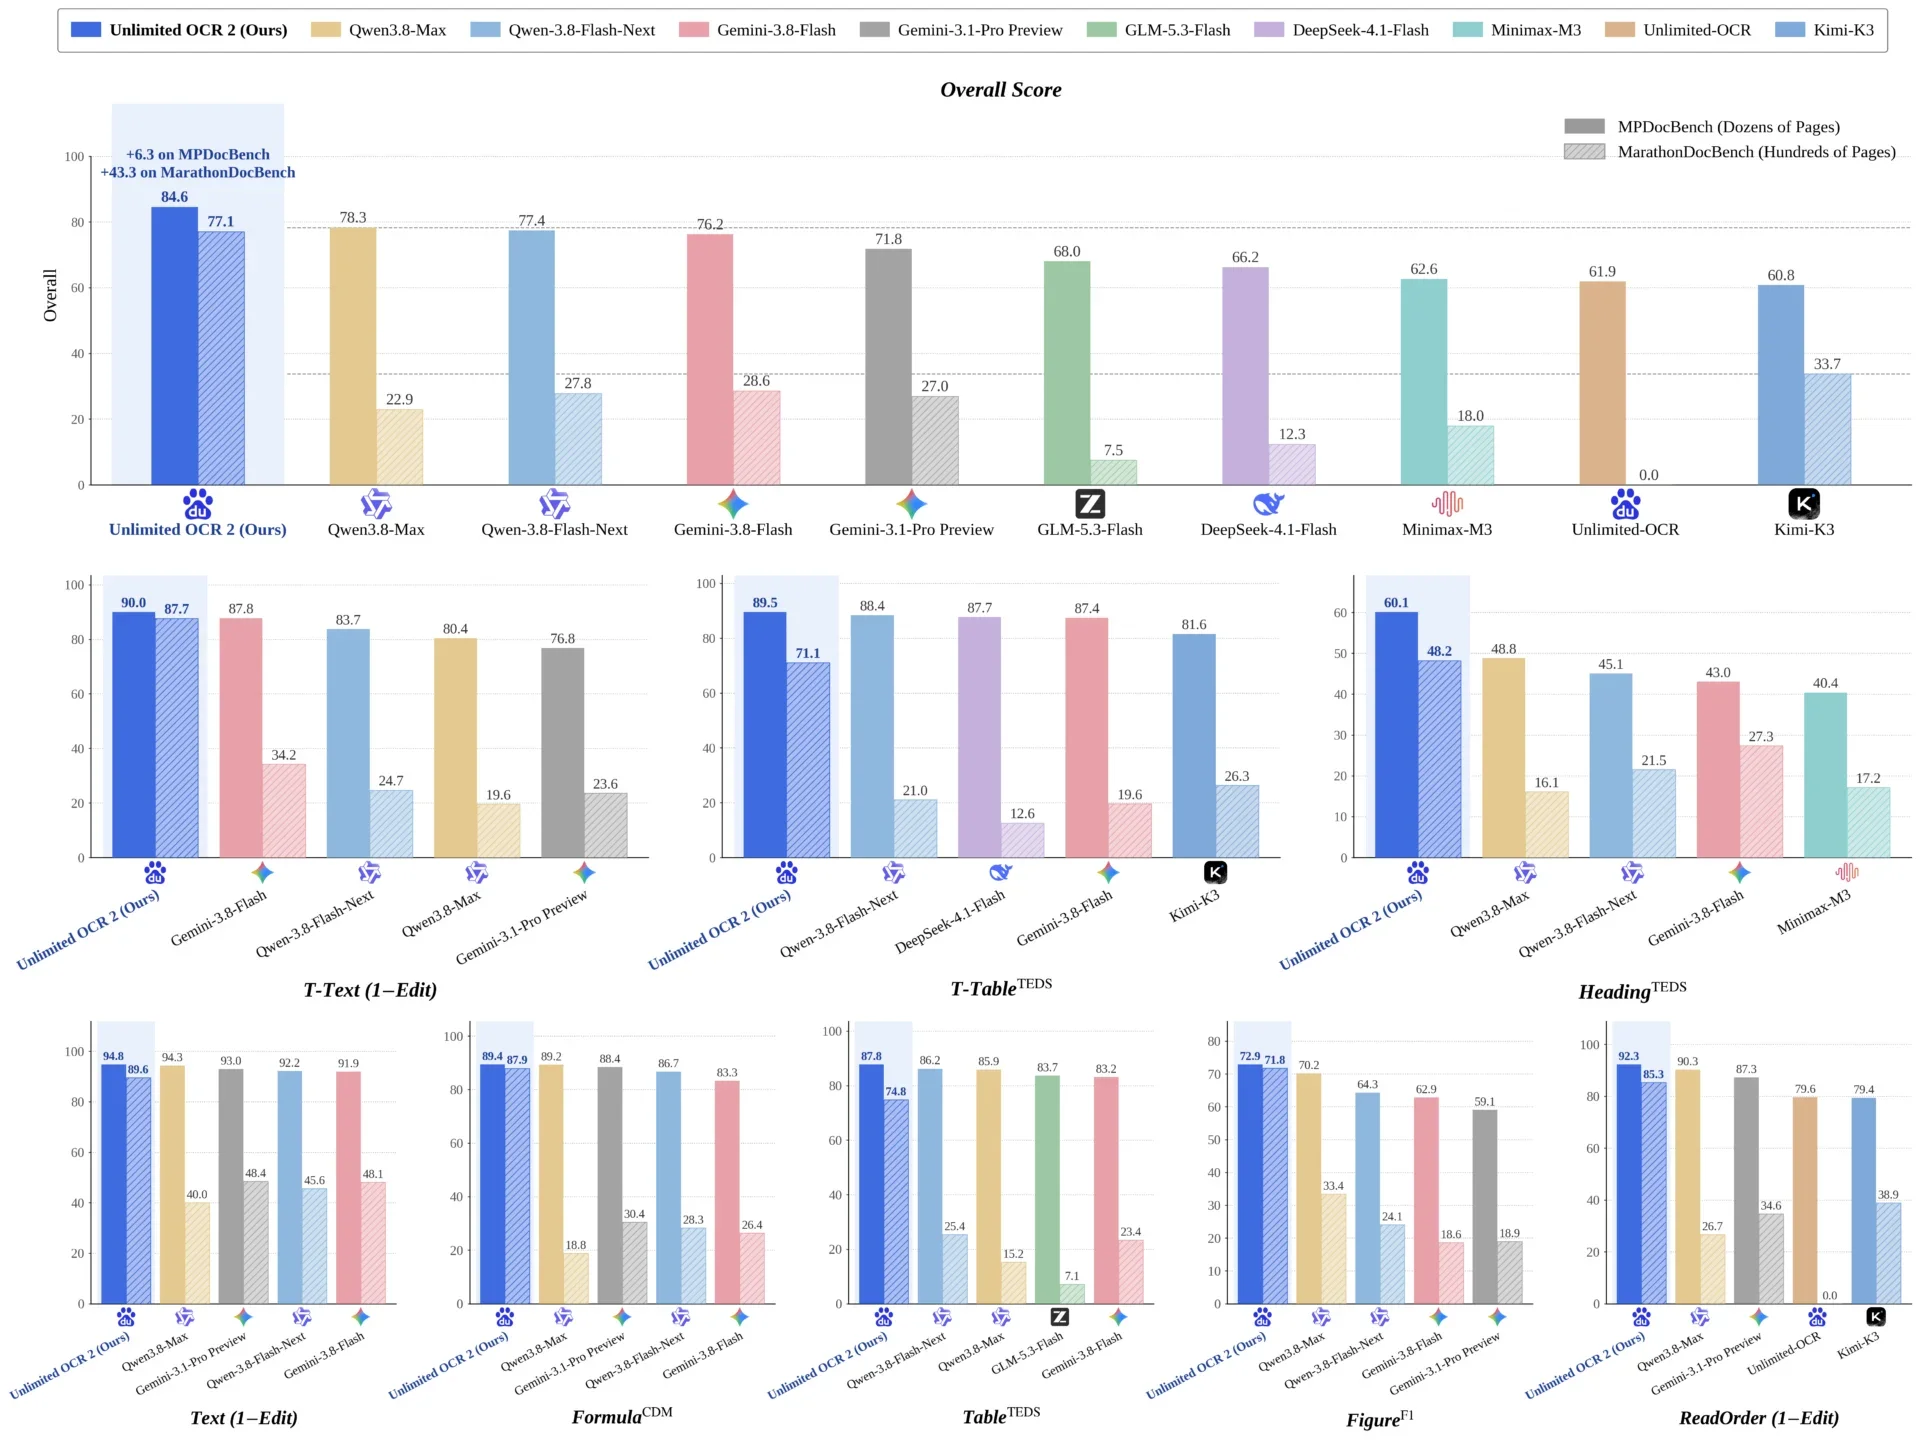
Baidu сообщает о высоких результатах на двух тестах: MPDocBench для документов длиной в десятки страниц и MarathonDocBench для файлов на сотни страниц. В опубликованной разработчиками диаграмме Unlimited OCR 2 набирает 84,6 балла на MPDocBench и 77,1 на MarathonDocBench. На графике также показаны результаты ряда других моделей и предыдущей версии Unlimited OCR.
Эти цифры следует читать как результаты, опубликованные командой проекта: независимая проверка конкретной конфигурации и условий тестирования может дать дополнительный контекст. Само наличие высокого балла на тестовом наборе не гарантирует такую же точность на сканах, таблицах и языках из любого рабочего архива.
Кому пригодится модель
Unlimited OCR 2 может быть полезна командам, которым нужно извлекать текст и структуру из объёмных PDF: исследовательских материалов, финансовых отчётов, архивных книг, технических руководств или договоров. Особенно важна возможность передать документ целиком, когда разбиение на независимые страницы теряет связи и нумерацию.
Это модель для разработчиков и организаций, которые собирают собственный конвейер обработки документов. Если нужна компактная система для распознавания страниц на CPU, посмотрите также Indra OCR — это другой сценарий использования, с упором на небольшой размер и локальный запуск.
Как запустить Unlimited OCR 2
Transformers для первых экспериментов
В официальном репозитории приведён пример запуска через Transformers: изображения страниц передаются методом infer_multi. Для этого нужно скачать веса и установить набор Python-зависимостей. Код модели загружается с параметром trust_remote_code=True, поэтому перед запуском стоит ознакомиться с файлами репозитория и выполнять их в доверенной среде.
SGLang для сервера
Для обслуживания запросов Baidu рекомендует SGLang. В инструкции используется специально собранная версия SGLang, поэтому это не подключение «в один клик» к любой готовой OCR-программе. Авторы проверяли пример с Transformers на NVIDIA A800 с 80 ГБ памяти; это описание тестовой конфигурации, а не официально заявленный минимальный порог для всех способов запуска.
Для обычного PDF его страницы сначала преобразуются в изображения. Результат можно получить в виде текста с разделителями страниц, а затем передать в поиск, архив или систему анализа документов.
Что означает слово Unlimited
Название не означает, что модель способна обработать буквально бесконечный документ без затрат времени и вычислительных ресурсов. Baidu говорит о неограниченной длине горизонта разбора в рамках архитектуры, где стоимость одного шага декодирования и объём рабочей памяти почти не растут с числом уже обработанных страниц.
Всё равно нужно загрузить и закодировать изображения страниц, выделить ресурсы для вычислений и задать бюджет текста на выходе. В режиме SGLang документация предлагает обрабатывать очень длинные файлы окнами страниц; уменьшение окна снижает пиковое потребление памяти, но может ослабить связи между фрагментами, которые пересекают границу окна.
Модель насчитывает около 3,34 млрд параметров, карточка Hugging Face указывает лицензию MIT. В документации показаны два пути запуска — Transformers для экспериментов и SGLang для серверной эксплуатации. Перед выбором для производственного архива стоит проверить качество на своих сканах, таблицах и языках.
Исходный код и инструкция доступны в репозитории Baidu, веса — в карточке модели на Hugging Face.